在 CES 展会上,最让我印象深刻的是英伟达和 AMD 对系统方法的重视程度,这可能是近年来计算机设计领域发生的最重大的变化。
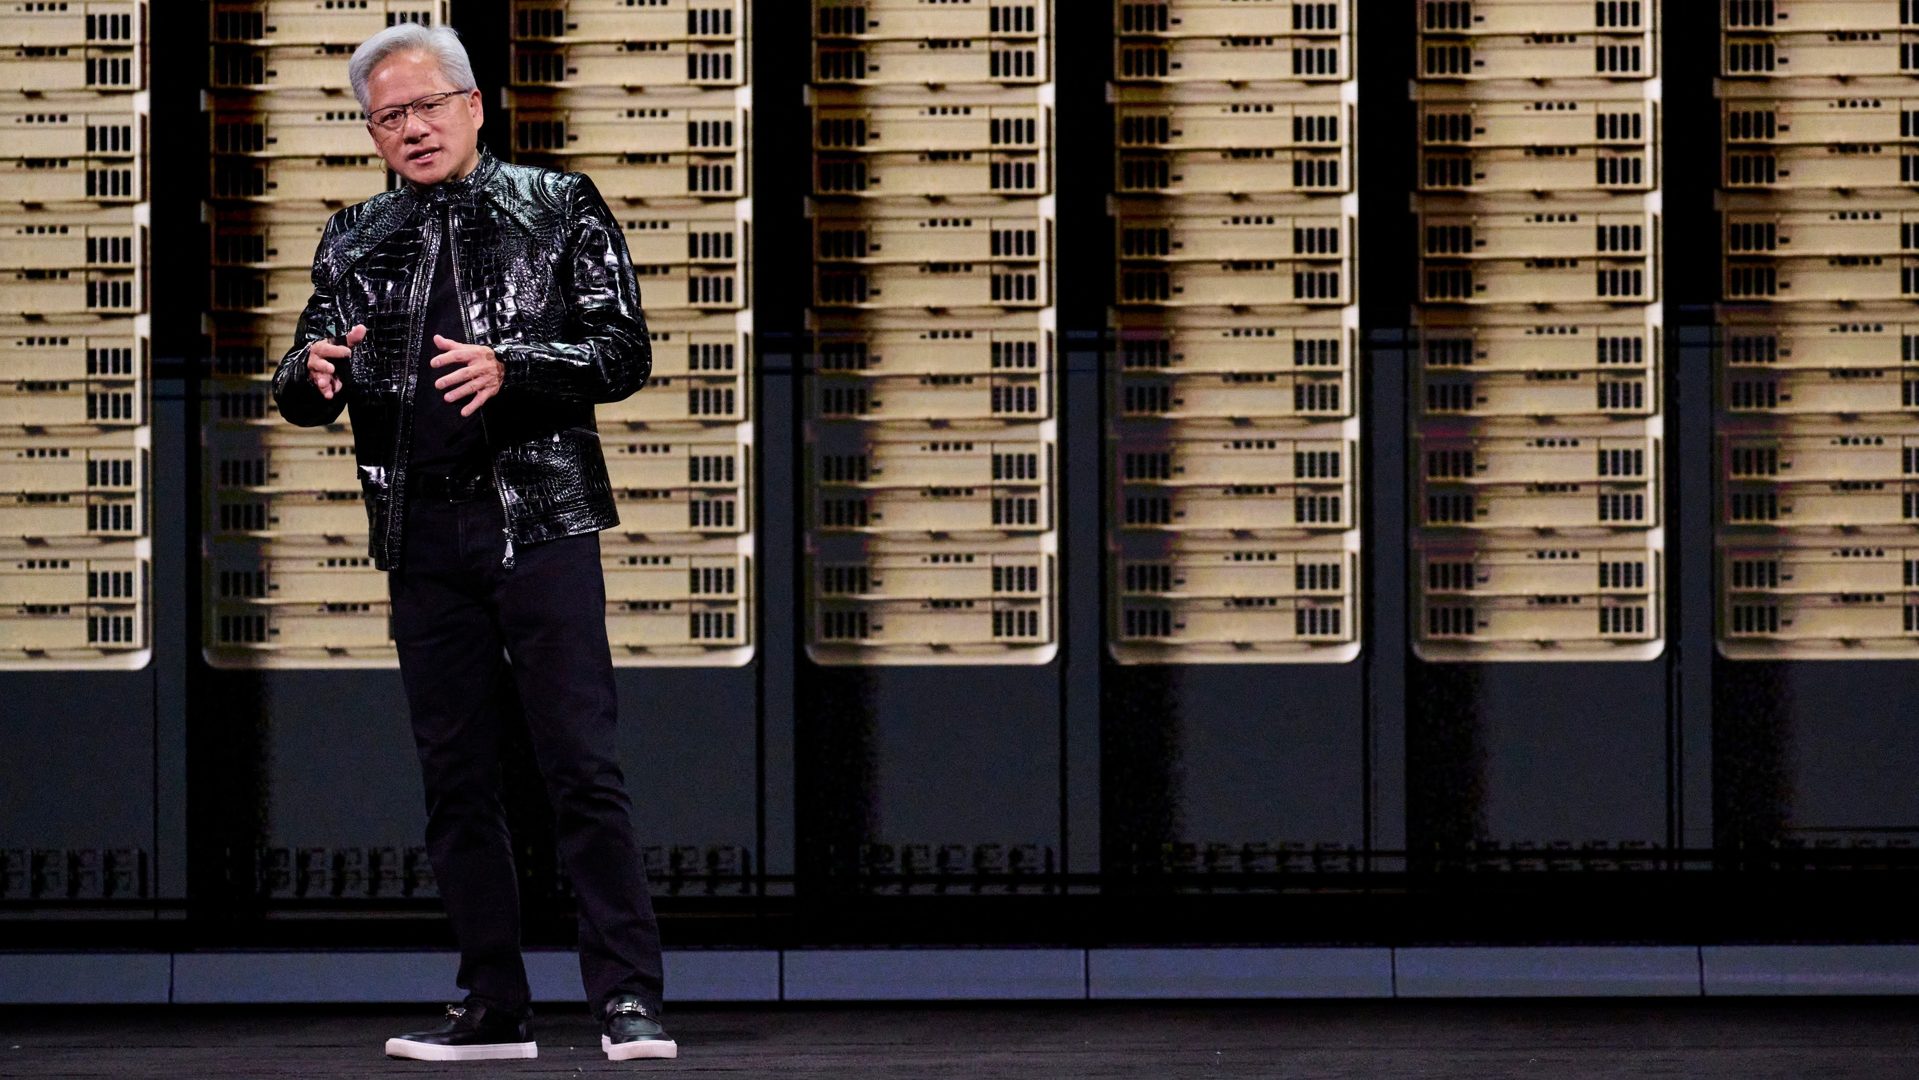 (图片来源:Bridget Bennett/Bloomberg via Getty Images)
过去几年,人工智能一直是科技趋势讨论的焦点。诚然,个人电脑运行速度更快、续航时间更长,手机可以拍摄出令人惊艳的照片,电视的画质也比以往任何时候都更好。但这些变化大多是渐进式的。最大的变化是大型语言模型的出现。聊天机器人以及,虽然仍处于早期阶段的人工智能代理。
这给系统设计带来了巨大影响。最新的个人电脑和手机现在都使用神经网络处理器(NPU)在本地运行人工智能模型。但服务器以及运行它们的数据中心的变化更为显著。虽然我们可能在很长一段时间内仍然需要传统的基于CPU的服务器,但所有的新应用都需要大量的图形处理单元(GPU),即使它们并不进行图形处理。
当然,这催生了各种新型和增强型芯片的出现,以运行这些应用。英伟达(Nvidia)引领了GPU通用化应用的潮流,目前大多数重要的AI训练仍然在其芯片上进行。该公司每年都会发布专为数据中心设计的新芯片。其长期竞争对手AMD也加入了这场竞争,尤其是在过去一年里,其Instinct系列芯片表现不俗。似乎所有大型云计算供应商——超大规模数据中心——都拥有专用的专有芯片来运行各自的AI应用,其中大多数都专注于推理,包括谷歌的TPU、亚马逊的Trainium和微软的Maia。所有这些芯片都在过去几个月里推出了新版本。
这使得传统的CPU架构相形见绌,迫使人工智能应用、系统和数据中心进行重新设计。事实上,对搭载此类芯片的新型数据中心的预期需求如此之大,以至于我们有理由相信它们将需要独立的电源。甚至有超大规模数据中心运营商正在讨论新建或重启核电站。
最近让我印象深刻的一点是,这如何影响了大型数据中心的系统设计。以前是由大型云服务提供商或少数几家大型计算机公司来设计系统,现在则是由GPU制造商——先是英伟达,现在AMD也加入了——不仅设计新的芯片和电路板,而且还设计包含构建服务器机架所需所有组件的完整系统。
在2026年国际消费电子展(CES)上,这一切显而易见。最吸引我眼球的并非最初令展会得名的消费电子产品,而是面向大型数据中心的服务器,包括AMD搭载最新Instinct显卡的Helios服务器和Nvidia采用其下一代架构的Vera Rubin服务器。令我印象深刻的是,这两家公司如今都如此注重系统化解决方案,不仅承诺提升性能,更承诺大幅提高效率。这或许是近年来计算机设计领域最具深远意义的变革。
英伟达的维拉·鲁宾
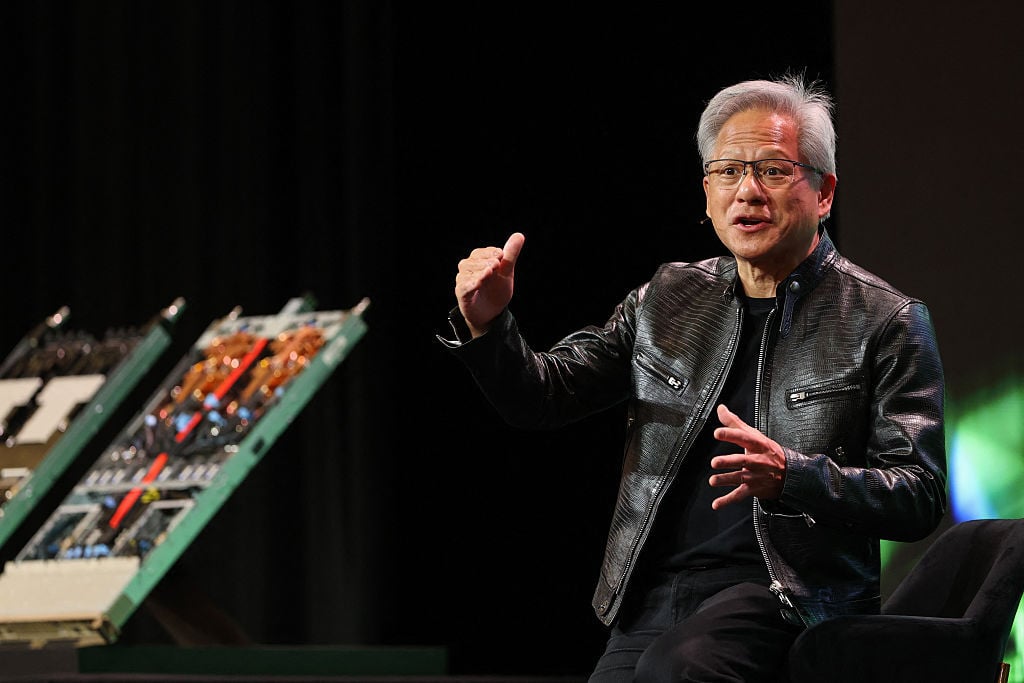
在CES展会上,英伟达CEO黄仁勋重点介绍了其Vera Rubin“AI工厂”,这是英伟达下一代数据中心服务器平台。这是一个完整的系统设计,不仅包含Rubin GPU和基于ARM架构的Vera CPU,还包括其他四款芯片:用于纵向扩展网络(即机架内部网络)的NVLink 6交换机、用于横向扩展网络(即机架间网络)的Spectrum-X以太网光子芯片、CX9网络接口卡以及BlueField 4数据处理单元。完整的Vera Rubin NVL72拥有72个GPU,英伟达称其在FP4(四位精度推理)下可提供50 petaflops的运算能力,此外还配备36个CPU。黄仁勋表示,该系统目前已投入生产。
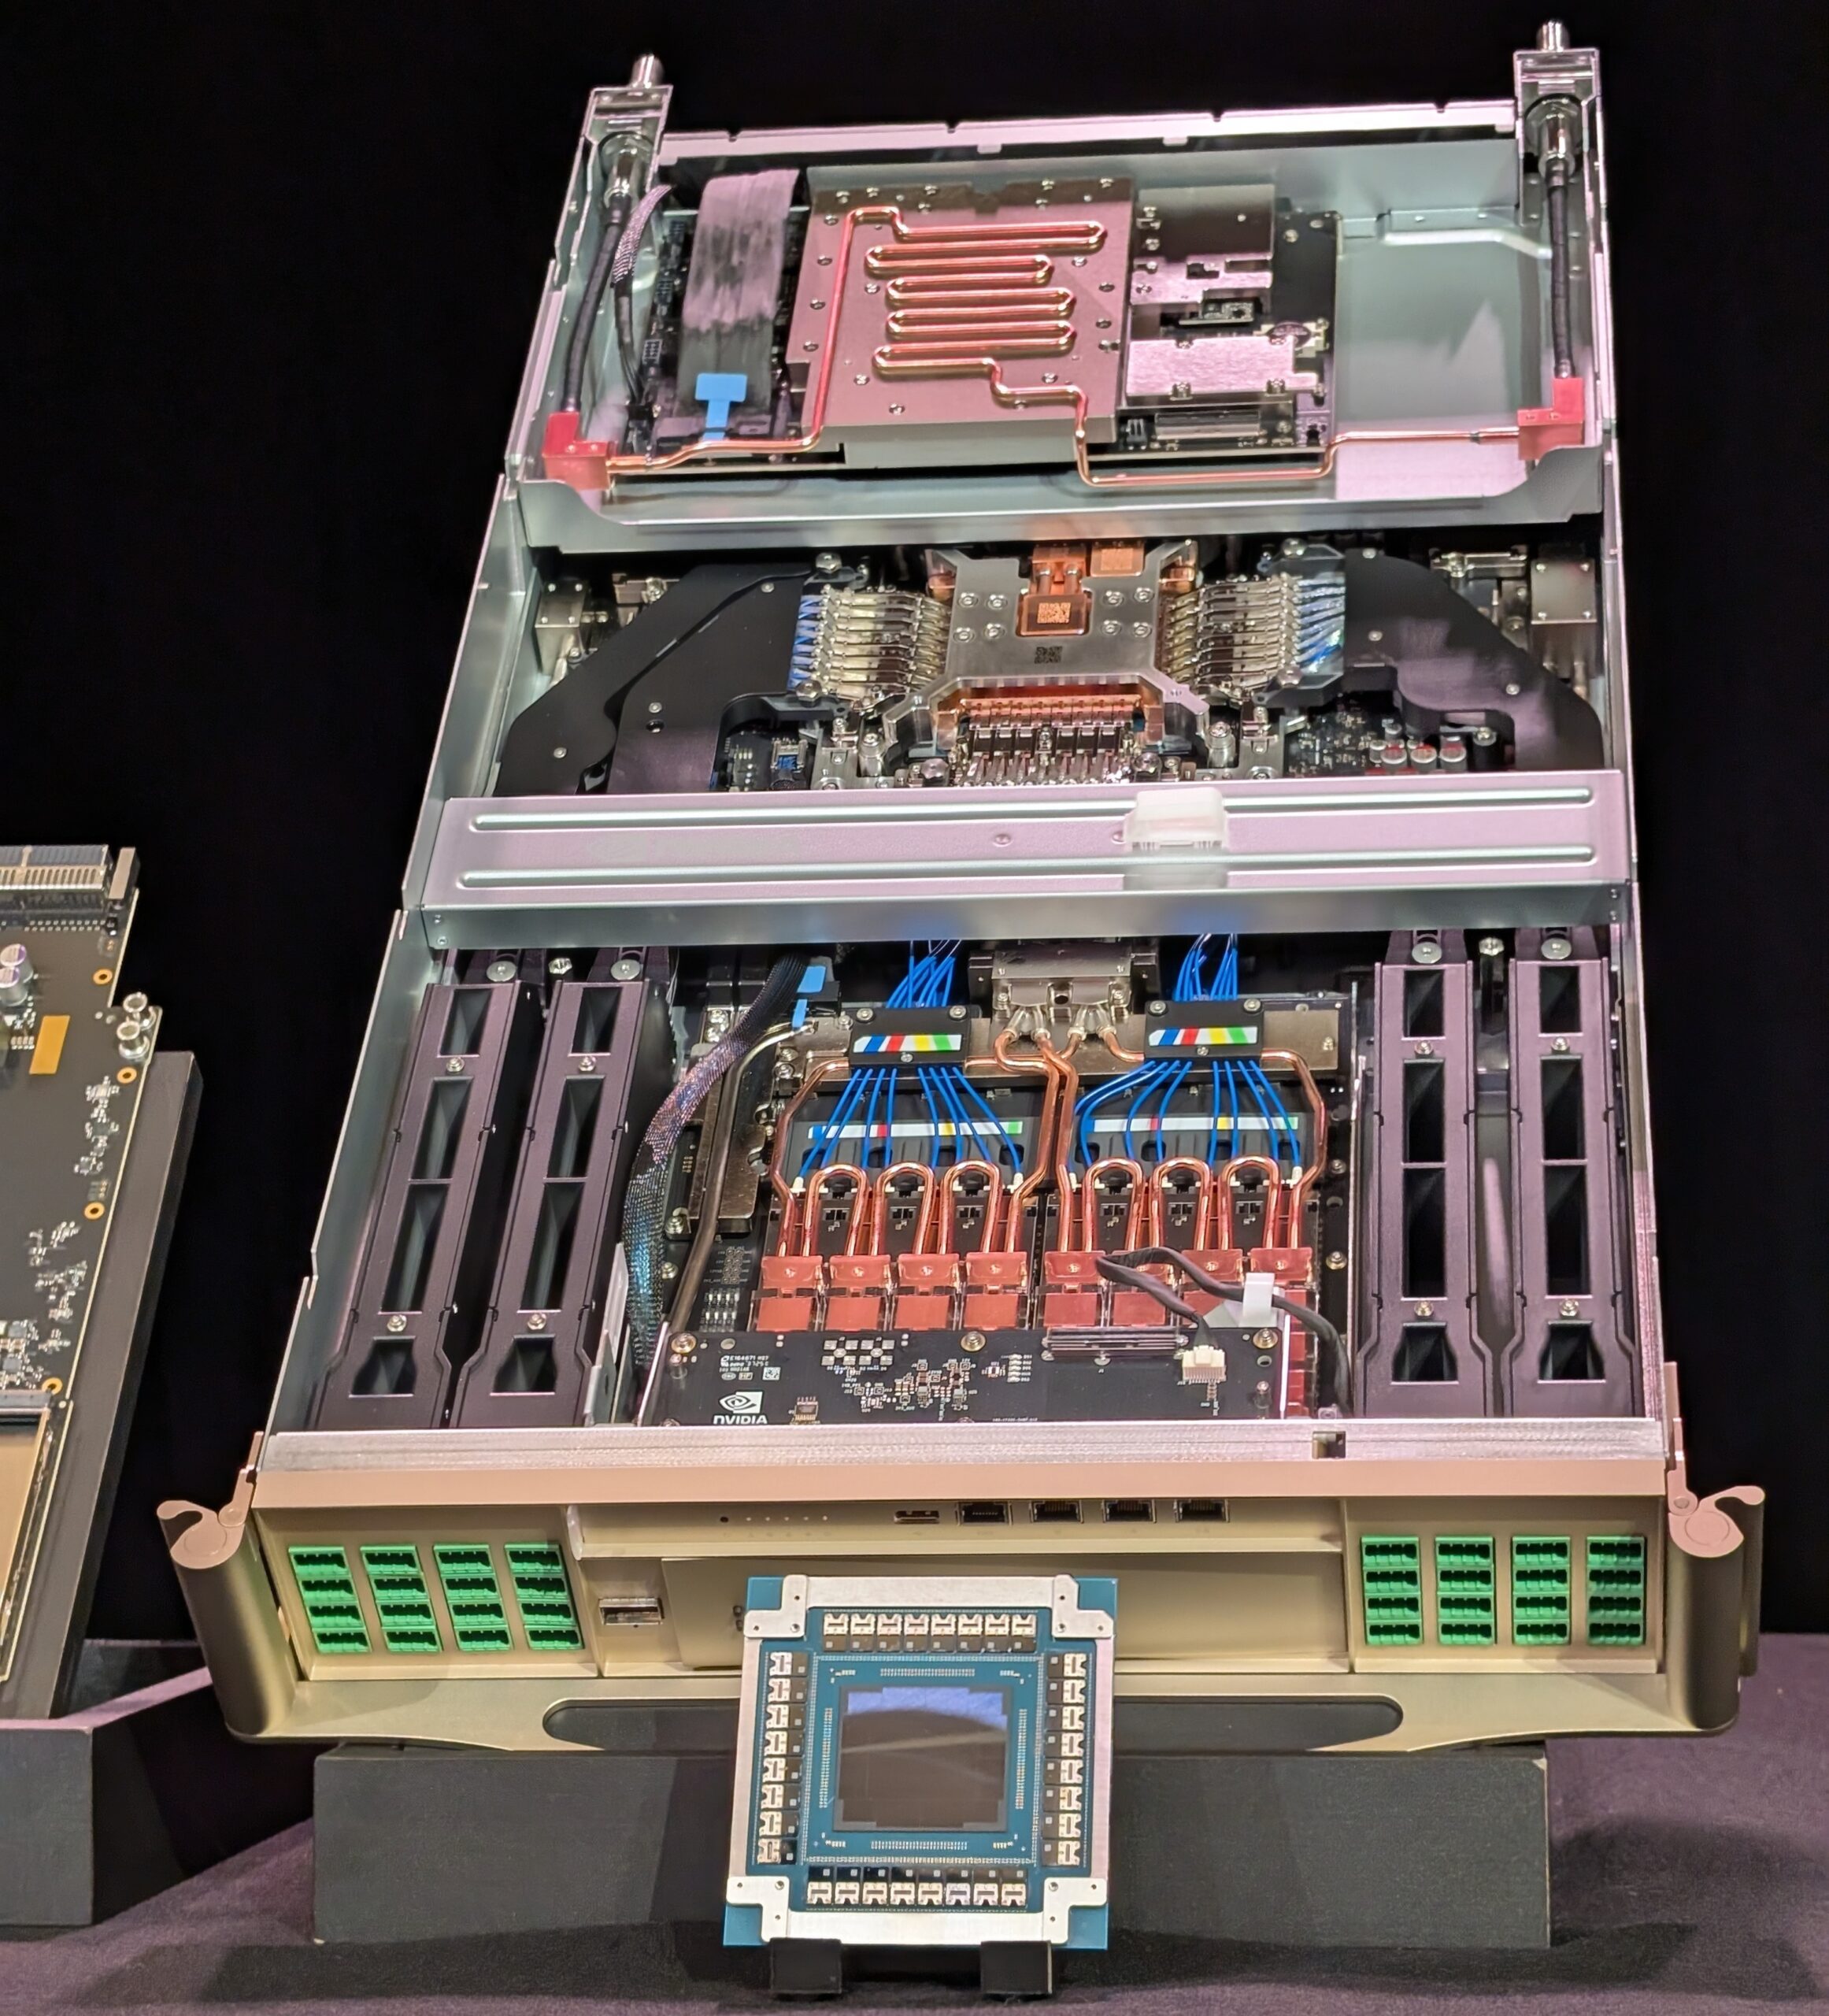
黄仁勋解释说:“人工智能所需的计算量正在飞速增长。”他指出,顶级模型每年参数数量增加10倍,而测试时的扩展或“推理”每年使用的令牌数量是原来的五倍。英伟达表示,其对系统中所有六个芯片进行协同设计的策略,使得公司能够将每个令牌的推理成本降低10倍,与基于当前Blackwell GPU的上一代服务器相比,优势显著。在随后的问答环节中,黄仁勋表示,这将使每瓦吞吐量提高5倍。
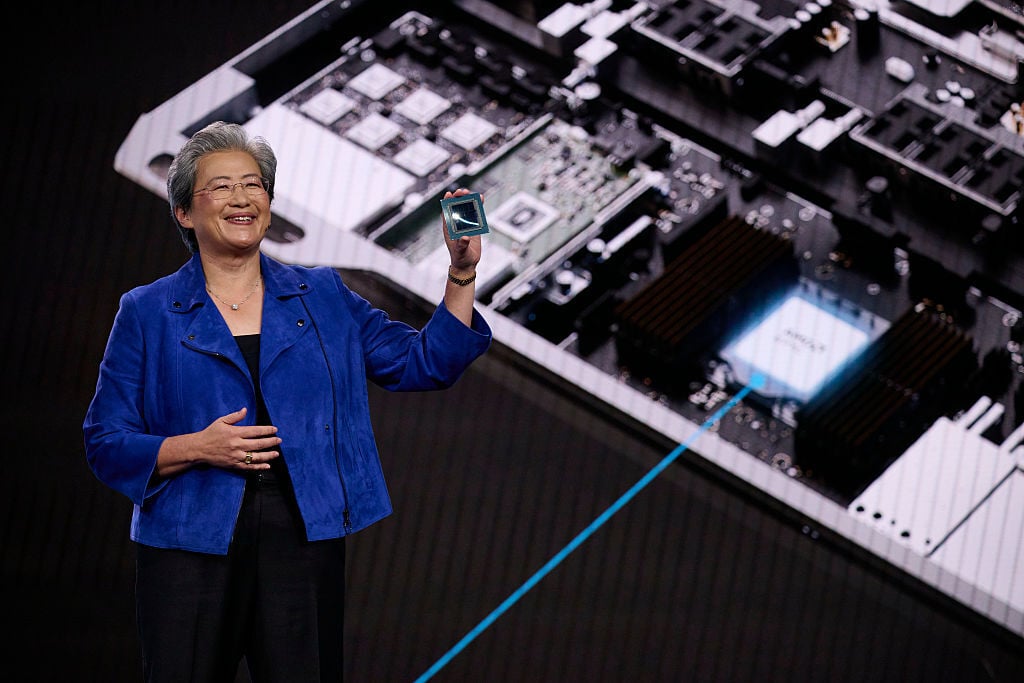
AMD首席执行官苏姿丰在CES主题演讲中同样掷地有声。她指出,人工智能的计算能力已经从2022年的1泽巴(万亿亿次浮点运算)增长到2025年的100泽巴以上。“我们目前的计算能力远远不足以完成所有可能的任务。”
“为了让人工智能无处不在,我们需要在未来几年内将全球计算能力提高 100 倍,在未来五年内达到 10 亿亿次浮点运算以上,”她说道,并指出这将是 2022 年计算能力的 1 万倍,也是计算机发展史上前所未有的飞跃。
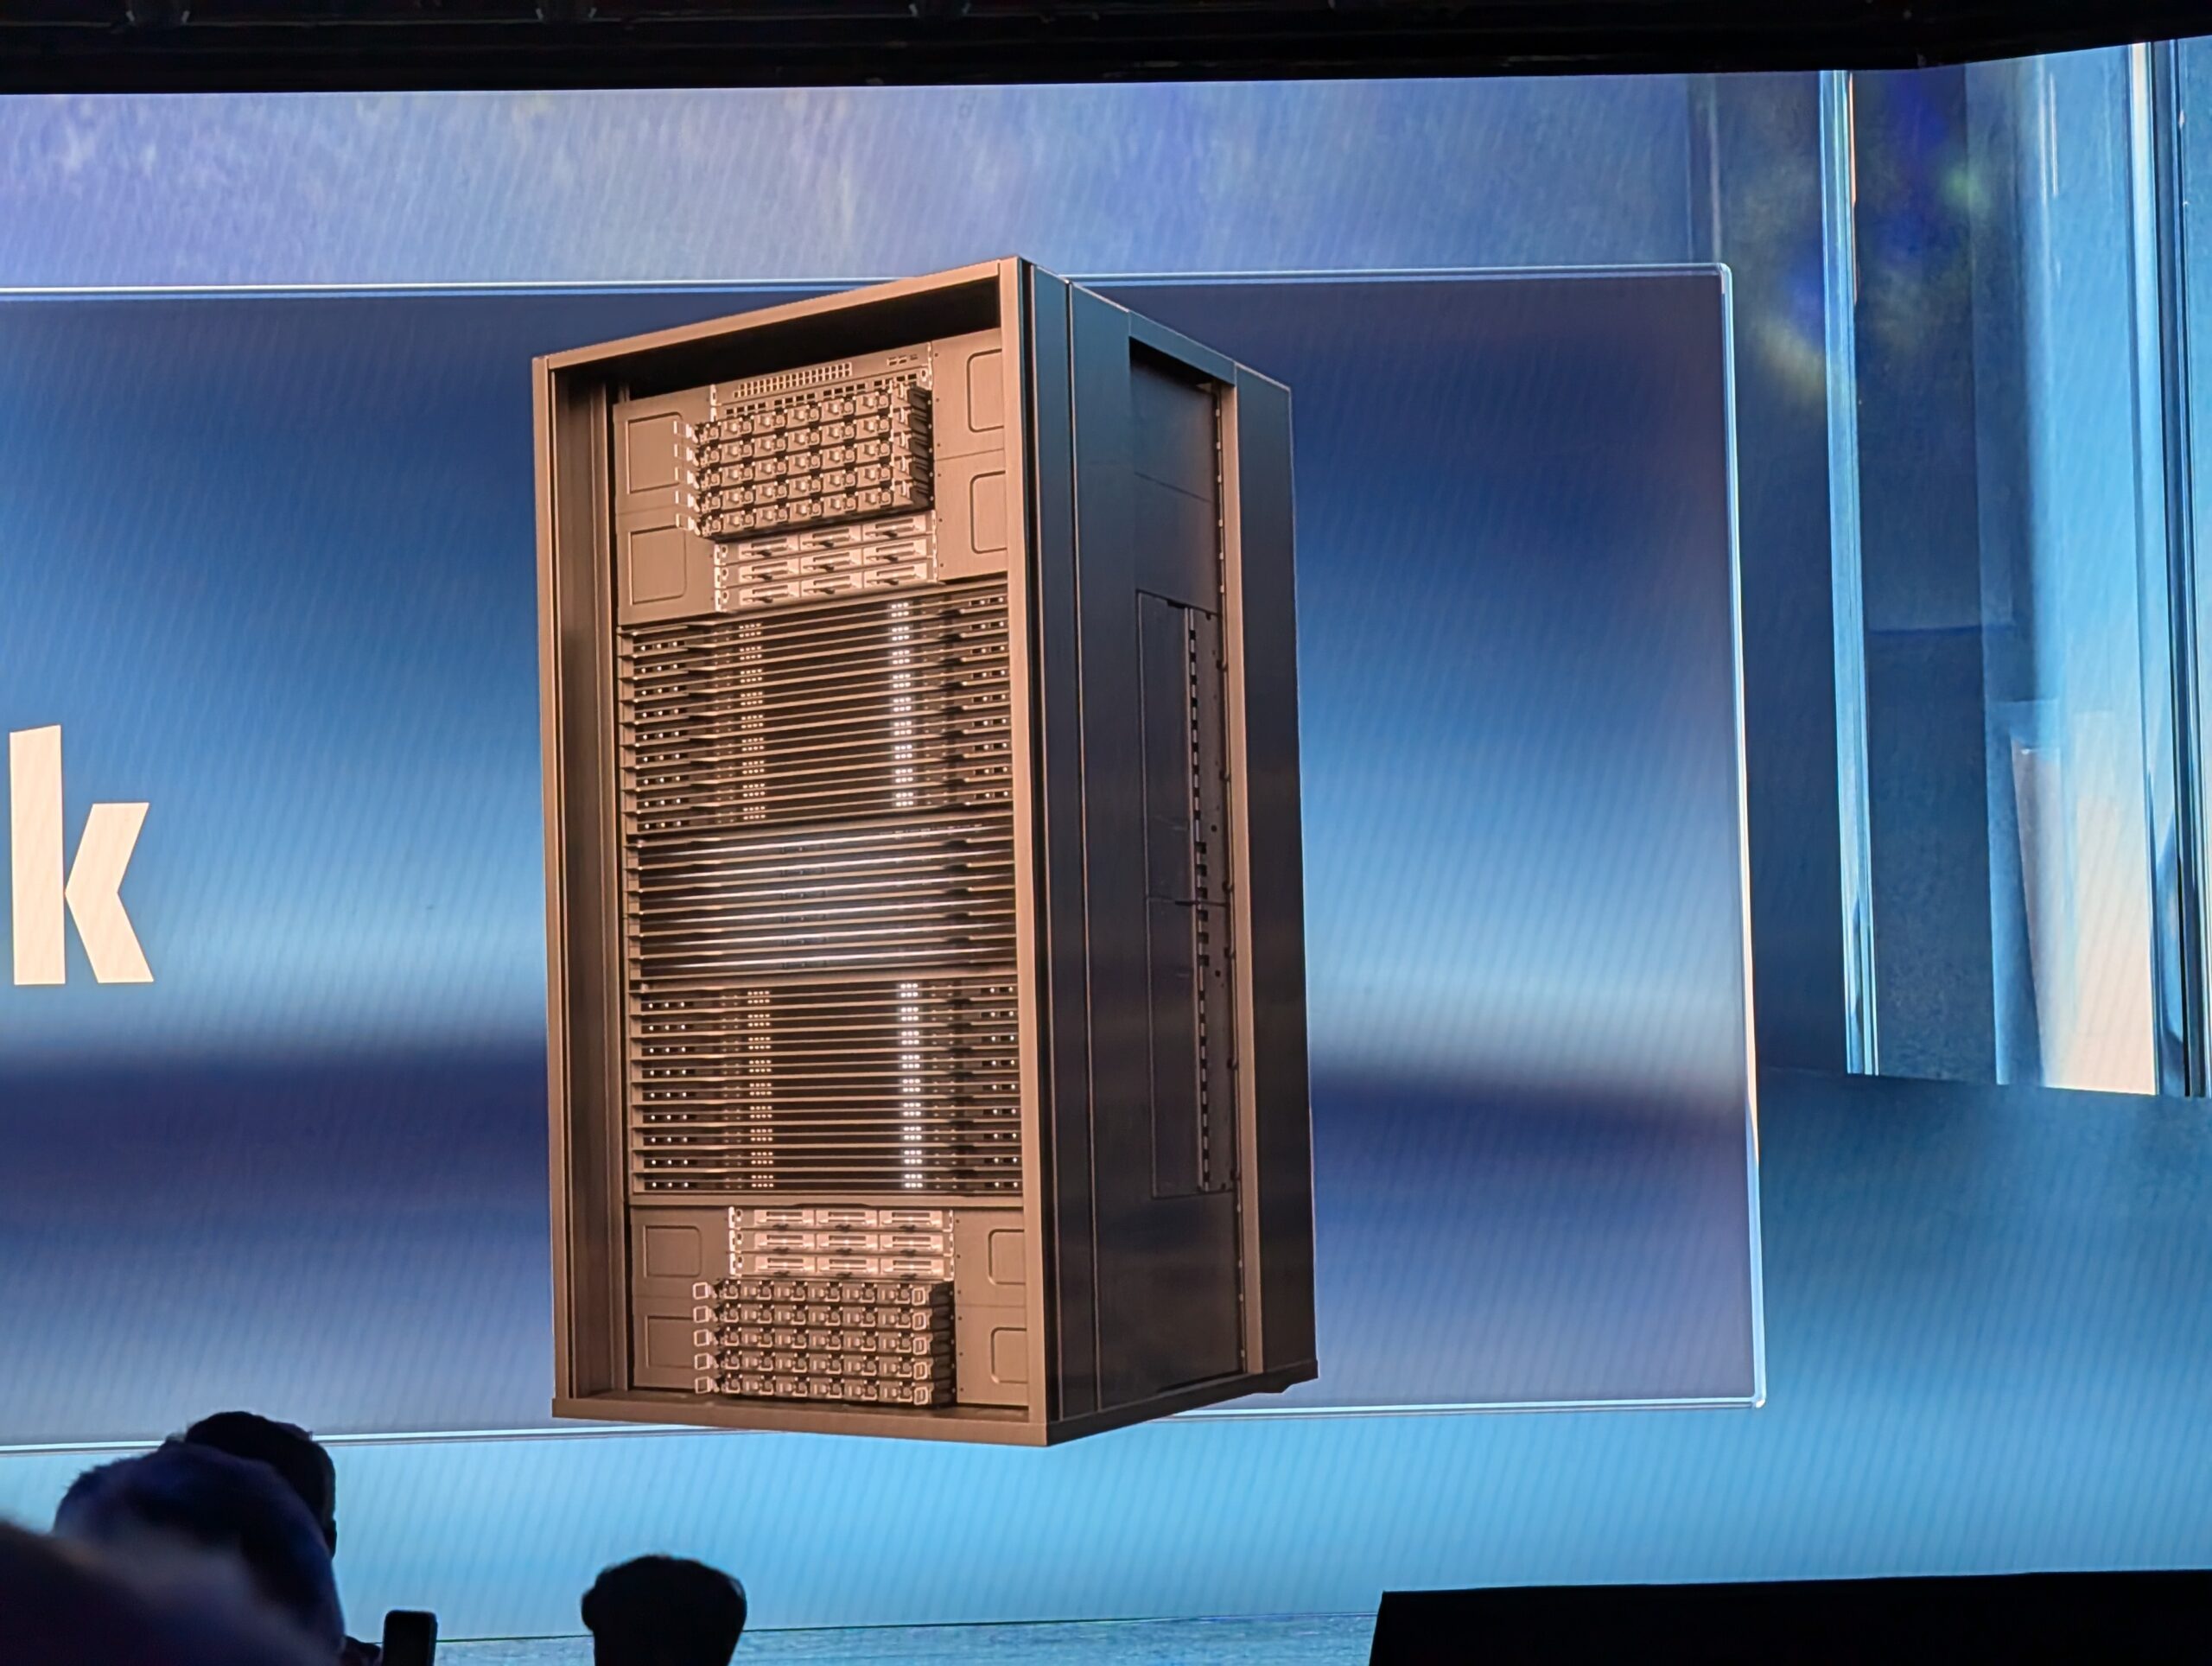
AMD针对此问题的解决方案是推出新一代Instinct GPU——MI455X,以及名为Helios的系统级产品。Helios包含配备超高速HBM4显存的Instinct MI455加速器、代号为Venice的全新Epyc CPU,以及两款Pensando DPU(数据处理单元)——一款是现有的Salian DPU,另一款是名为Vulcano的全新DPU,后者可提供更快的UltraEthernet,用于横向扩展计算。该系统每个机架可容纳72个GPU,苏姿丰表示,这将带来2.9 Exaflops的AI计算能力,拥有4600个CPU核心、18000个GPU计算单元和31TB的HBM4显存。该产品将于今年晚些时候发布。明年的芯片——MI500系列——速度将提升10倍,苏姿丰承诺,四年内,这些技术的组合将使AI性能提升1000倍。
为什么系统聚焦很重要
1000 倍的提升令人惊叹——远远超出摩尔定律预期的发展速度,而摩尔定律的实际增速实际上已经放缓。这得益于芯片层面的改进,例如更快的内存连接;以及系统层面的改进,即系统各个部分协同工作的设计。当然,人工智能软件的设计者们也在致力于提升系统的效率。
所有这些改进都至关重要,因为如果人工智能和智能代理的使用持续增长,我们将需要新的系统和新的数据中心来运行这些应用程序。人们可能会认为,成本降低只会增加需求。但是,能够快速建造的数据中心数量有限,因此提高它们的效率——让每台服务器处理更多事务并降低每笔事务的能耗——至关重要。
尽管所有大型人工智能企业和超大规模数据中心运营商都承诺建设新的数据中心,但这些建设都受到可用电力容量的限制。新增发电量的增长速度远不及数据中心的需求增长速度,因此,提高电力效率至关重要。
混合人工智能
我在CES上注意到的另一个大趋势是,各大厂商都在越来越关注“混合人工智能”。AMD、英伟达、英特尔、联想和高通都在各自的主题演讲和新闻发布会上使用了这个词。但它的具体含义却不尽相同。
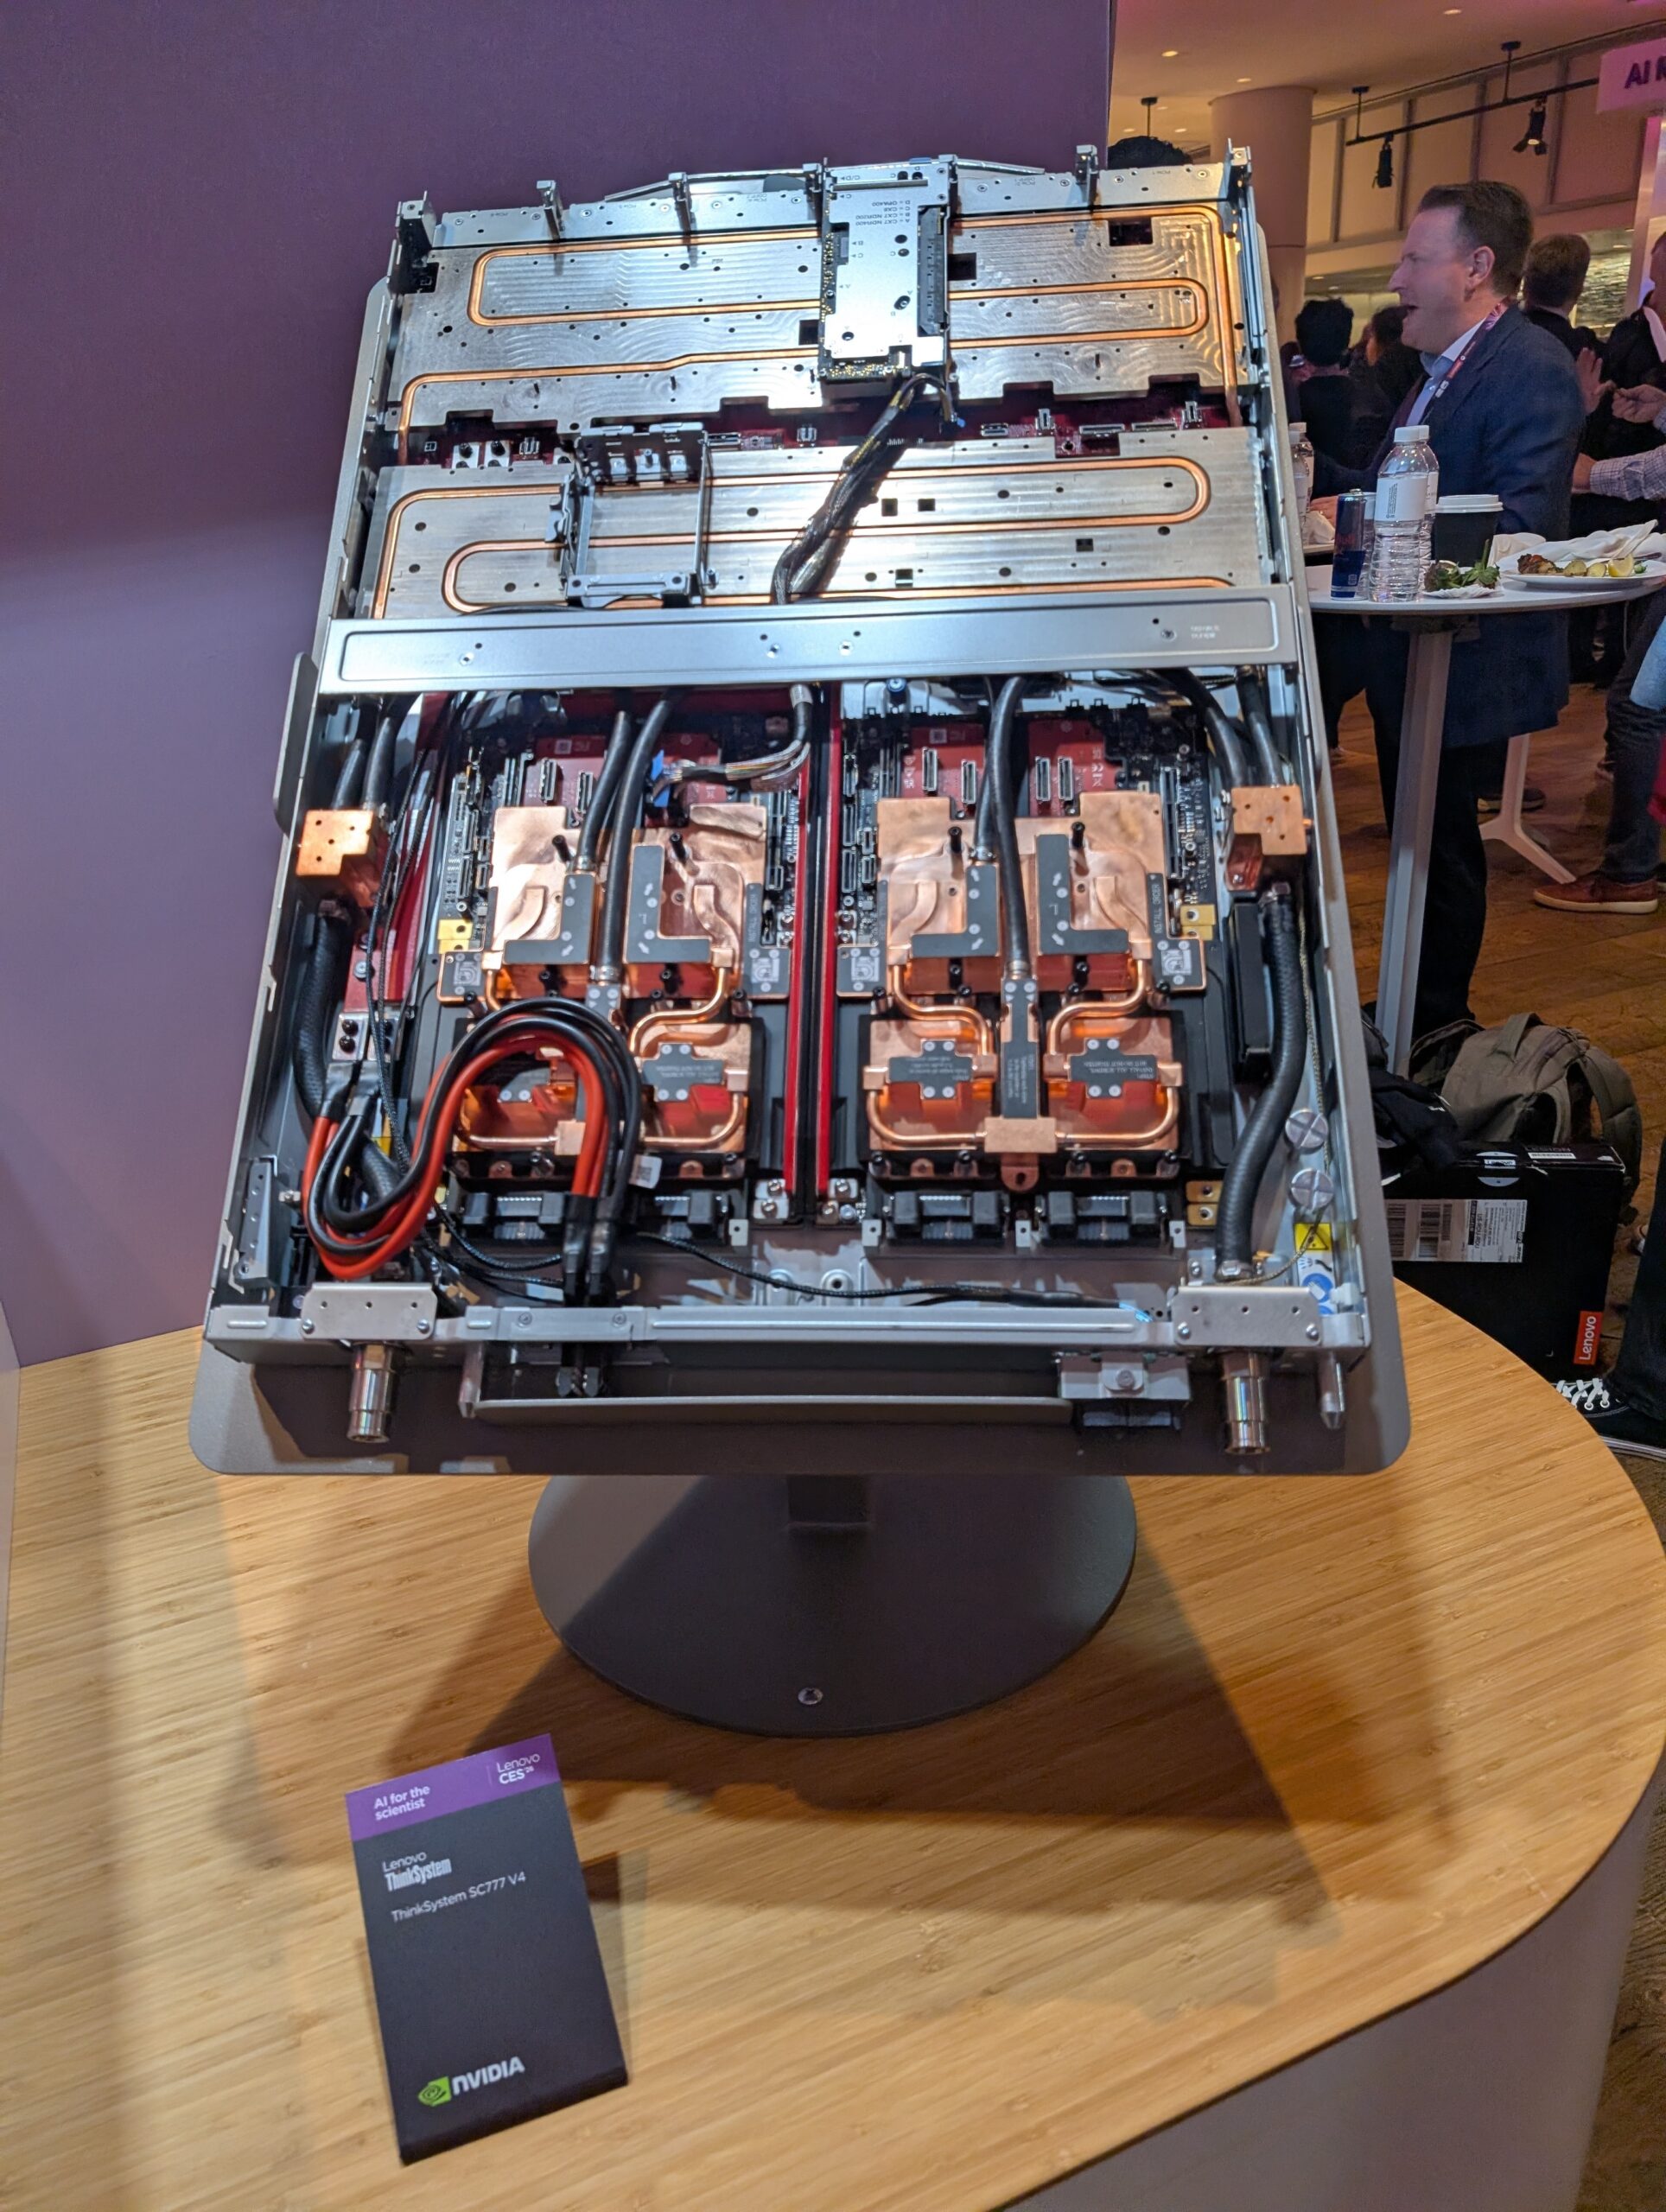
英伟达谈到了三种人工智能:训练、推理和模拟。AMD、英特尔和联想都谈到了数据中心服务器和“边缘”服务器提供的推理功能。AMD、英特尔和高通都谈到了在PC上运行本地AI模型,微软近几个月来也一直在谈论这一点。高通和联想(及其摩托罗拉产品线)则谈到了在手机上运行AI。
人工智能在各大领域的影响力显而易见,它已经主导了科技领域的讨论。展会上几乎所有消费电子产品都与人工智能有关,尽管大多数只是对已推出多年的技术进行升级(例如改进电视的图像处理),或者只是软件的另一种说法。
毫无疑问,在人工智能的推动下,设备、我们运行的应用程序、传统个人软件和商业应用都在经历重大变革。许多变化已经发生,但更大的变革尚未到来。
在 CES 展会上,最让我印象深刻的是英伟达和 AMD 对系统方法的重视程度,这可能是近年来计算机设计领域发生的最重大的变化。
(图片来源:Bridget Bennett/Bloomberg via Getty Images)
过去几年,人工智能一直是科技趋势讨论的焦点。诚然,个人电脑运行速度更快、续航时间更长,手机可以拍摄出令人惊艳的照片,电视的画质也比以往任何时候都更好。但这些变化大多是渐进式的。最大的变化是大型语言模型的出现。聊天机器人以及,虽然仍处于早期阶段的人工智能代理。
这给系统设计带来了巨大影响。最新的个人电脑和手机现在都使用神经网络处理器(NPU)在本地运行人工智能模型。但服务器以及运行它们的数据中心的变化更为显著。虽然我们可能在很长一段时间内仍然需要传统的基于CPU的服务器,但所有的新应用都需要大量的图形处理单元(GPU),即使它们并不进行图形处理。
当然,这催生了各种新型和增强型芯片的出现,以运行这些应用。英伟达(Nvidia)引领了GPU通用化应用的潮流,目前大多数重要的AI训练仍然在其芯片上进行。该公司每年都会发布专为数据中心设计的新芯片。其长期竞争对手AMD也加入了这场竞争,尤其是在过去一年里,其Instinct系列芯片表现不俗。似乎所有大型云计算供应商——超大规模数据中心——都拥有专用的专有芯片来运行各自的AI应用,其中大多数都专注于推理,包括谷歌的TPU、亚马逊的Trainium和微软的Maia。所有这些芯片都在过去几个月里推出了新版本。
这使得传统的CPU架构相形见绌,迫使人工智能应用、系统和数据中心进行重新设计。事实上,对搭载此类芯片的新型数据中心的预期需求如此之大,以至于我们有理由相信它们将需要独立的电源。甚至有超大规模数据中心运营商正在讨论新建或重启核电站。
最近让我印象深刻的一点是,这如何影响了大型数据中心的系统设计。以前是由大型云服务提供商或少数几家大型计算机公司来设计系统,现在则是由GPU制造商——先是英伟达,现在AMD也加入了——不仅设计新的芯片和电路板,而且还设计包含构建服务器机架所需所有组件的完整系统。
在2026年国际消费电子展(CES)上,这一切显而易见。最吸引我眼球的并非最初令展会得名的消费电子产品,而是面向大型数据中心的服务器,包括AMD搭载最新Instinct显卡的Helios服务器和Nvidia采用其下一代架构的Vera Rubin服务器。令我印象深刻的是,这两家公司如今都如此注重系统化解决方案,不仅承诺提升性能,更承诺大幅提高效率。这或许是近年来计算机设计领域最具深远意义的变革。
英伟达的维拉·鲁宾
在CES展会上,英伟达CEO黄仁勋重点介绍了其Vera Rubin“AI工厂”,这是英伟达下一代数据中心服务器平台。这是一个完整的系统设计,不仅包含Rubin GPU和基于ARM架构的Vera CPU,还包括其他四款芯片:用于纵向扩展网络(即机架内部网络)的NVLink 6交换机、用于横向扩展网络(即机架间网络)的Spectrum-X以太网光子芯片、CX9网络接口卡以及BlueField 4数据处理单元。完整的Vera Rubin NVL72拥有72个GPU,英伟达称其在FP4(四位精度推理)下可提供50 petaflops的运算能力,此外还配备36个CPU。黄仁勋表示,该系统目前已投入生产。
黄仁勋解释说:“人工智能所需的计算量正在飞速增长。”他指出,顶级模型每年参数数量增加10倍,而测试时的扩展或“推理”每年使用的令牌数量是原来的五倍。英伟达表示,其对系统中所有六个芯片进行协同设计的策略,使得公司能够将每个令牌的推理成本降低10倍,与基于当前Blackwell GPU的上一代服务器相比,优势显著。在随后的问答环节中,黄仁勋表示,这将使每瓦吞吐量提高5倍。
AMD首席执行官苏姿丰在CES主题演讲中同样掷地有声。她指出,人工智能的计算能力已经从2022年的1泽巴(万亿亿次浮点运算)增长到2025年的100泽巴以上。“我们目前的计算能力远远不足以完成所有可能的任务。”
“为了让人工智能无处不在,我们需要在未来几年内将全球计算能力提高 100 倍,在未来五年内达到 10 亿亿次浮点运算以上,”她说道,并指出这将是 2022 年计算能力的 1 万倍,也是计算机发展史上前所未有的飞跃。
AMD针对此问题的解决方案是推出新一代Instinct GPU——MI455X,以及名为Helios的系统级产品。Helios包含配备超高速HBM4显存的Instinct MI455加速器、代号为Venice的全新Epyc CPU,以及两款Pensando DPU(数据处理单元)——一款是现有的Salian DPU,另一款是名为Vulcano的全新DPU,后者可提供更快的UltraEthernet,用于横向扩展计算。该系统每个机架可容纳72个GPU,苏姿丰表示,这将带来2.9 Exaflops的AI计算能力,拥有4600个CPU核心、18000个GPU计算单元和31TB的HBM4显存。该产品将于今年晚些时候发布。明年的芯片——MI500系列——速度将提升10倍,苏姿丰承诺,四年内,这些技术的组合将使AI性能提升1000倍。
为什么系统聚焦很重要
1000 倍的提升令人惊叹——远远超出摩尔定律预期的发展速度,而摩尔定律的实际增速实际上已经放缓。这得益于芯片层面的改进,例如更快的内存连接;以及系统层面的改进,即系统各个部分协同工作的设计。当然,人工智能软件的设计者们也在致力于提升系统的效率。
所有这些改进都至关重要,因为如果人工智能和智能代理的使用持续增长,我们将需要新的系统和新的数据中心来运行这些应用程序。人们可能会认为,成本降低只会增加需求。但是,能够快速建造的数据中心数量有限,因此提高它们的效率——让每台服务器处理更多事务并降低每笔事务的能耗——至关重要。
尽管所有大型人工智能企业和超大规模数据中心运营商都承诺建设新的数据中心,但这些建设都受到可用电力容量的限制。新增发电量的增长速度远不及数据中心的需求增长速度,因此,提高电力效率至关重要。
混合人工智能
我在CES上注意到的另一个大趋势是,各大厂商都在越来越关注“混合人工智能”。AMD、英伟达、英特尔、联想和高通都在各自的主题演讲和新闻发布会上使用了这个词。但它的具体含义却不尽相同。
英伟达谈到了三种人工智能:训练、推理和模拟。AMD、英特尔和联想都谈到了数据中心服务器和“边缘”服务器提供的推理功能。AMD、英特尔和高通都谈到了在PC上运行本地AI模型,微软近几个月来也一直在谈论这一点。高通和联想(及其摩托罗拉产品线)则谈到了在手机上运行AI。
人工智能在各大领域的影响力显而易见,它已经主导了科技领域的讨论。展会上几乎所有消费电子产品都与人工智能有关,尽管大多数只是对已推出多年的技术进行升级(例如改进电视的图像处理),或者只是软件的另一种说法。
毫无疑问,在人工智能的推动下,设备、我们运行的应用程序、传统个人软件和商业应用都在经历重大变革。许多变化已经发生,但更大的变革尚未到来。